
5回ぐるぐる見回されて先生になる Stanford Bunny
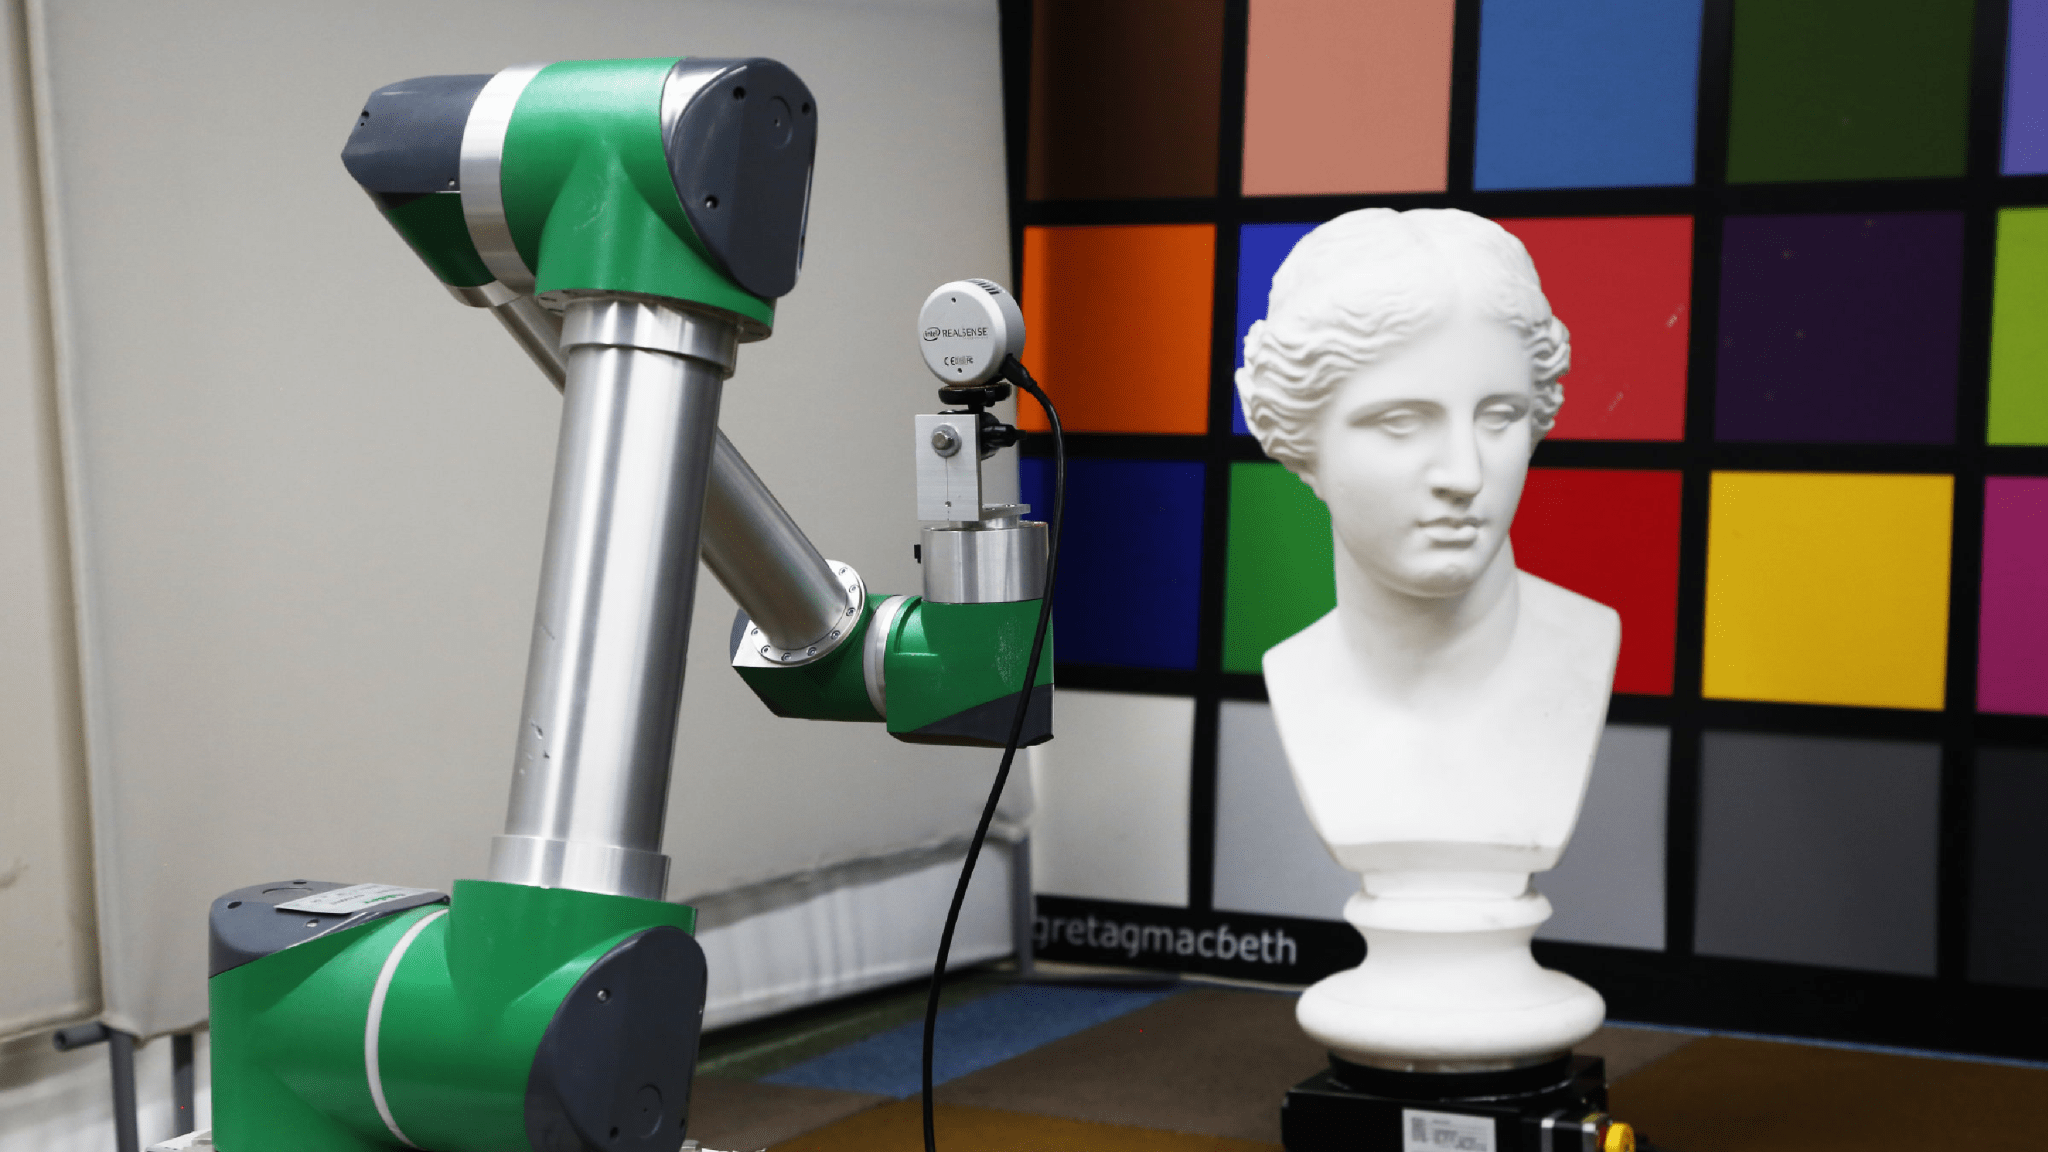
ScanDPの実機実験の写真。I. Hirako et al., “ScanDP: Generalizable 3D Scanning with Diffusion Policy”, Figure 1の写真部分です。Stanford Bunnyを使う学習シミュレーションとは別の実機の場面を示しています。
画像は著者公開GitHubのteaser_real.pngから変更せず取得しています。Copyright (c) 2026 Treeitsuki。MIT Licenseの著作権表示・許諾文・免責条項は同梱の全文に掲載しています。取得元のライセンスも参照できます。

今回のStanford bunny
Stanford bunnyは、シミュレーション実験のtrainingに使う唯一の物体です。仮想RGB-D cameraを人が操作して5本のscanning trajectoryを収集し、各trajectoryは500 stepで構成されます。
この少数のdemonstrationからDiffusion Policyを学習し、学習時に見ていない形状やscaleへscan軌道を生成します。実機評価には別途収集した5本の実環境軌道で学習したpolicyを使うため、実機までこのシミュレーションdataだけで学習したわけではありません。
つまり今回は仮想世界で5回ぐるぐる見回されたあと、他の形をどう見回るかを教える先生役です。
今回の扱い:シミュレーションの5 trajectory × 500 stepがtraining dataになる
状態:無傷(シミュレーション)
論文の内容
観測を蓄積して軌道を生成する
robotic scanningでは、観測済みの場所とまだ隠れている場所を把握しながらcameraを動かす必要があります。ScanDPはdepth観測をoccupancy grid map(OGM)へ蓄積し、camera姿勢とともにDiffusion Policyの入力にします。
policyは条件に応じてaction sequenceを段階的にdenoiseし、次のcamera軌道を生成します。OGMによって、それまでの観測を含む空間の状態を利用します。
生成したpathを最適化する
生成したactionには、空き空間のsphere表現を使った衝突filterとviewpointの選択を適用します。軌道の安全性とscan効率を改善し、冗長な動きを減らす構成です。
シミュレーションと実機を分けて評価する
シミュレーションでは人が示した少数のdemonstrationから学習し、未知形状や異なるscale、sensor noiseに対するcoverageと移動距離を比較します。
実機ではRGB-D sensor、6-DoF manipulator、turntableを使います。実環境で収集した5本のtrajectoryで別途学習し、trainingに含めなかった物体で評価します。
制約
OGMのgridを細かく保ったまま対象空間を広げると、計算資源が課題になります。また、人の動きに基づくtraining dataをロボットの運動学へ合わせるためのdomain adaptationも必要です。
論文情報
ScanDP: Generalizable 3D Scanning with Diffusion Policy
- arXiv: https://arxiv.org/abs/2603.10390
- Venue: IROS 2026
- 分野: Robotics / 3D Scanning / Diffusion Policy
- 使用モデル: Stanford bunny
- 使用箇所: シミュレーションのtraining experiments(Section IV-A)
- シミュレーションtraining trajectories: 5
- シミュレーションsteps per trajectory: 500
- 実機: 別途収集した5 trajectoryで学習
- 用途: シミュレーションpolicyのtrainingと未知形状へのscanning評価