
AIに巡回される Stanford Bunny
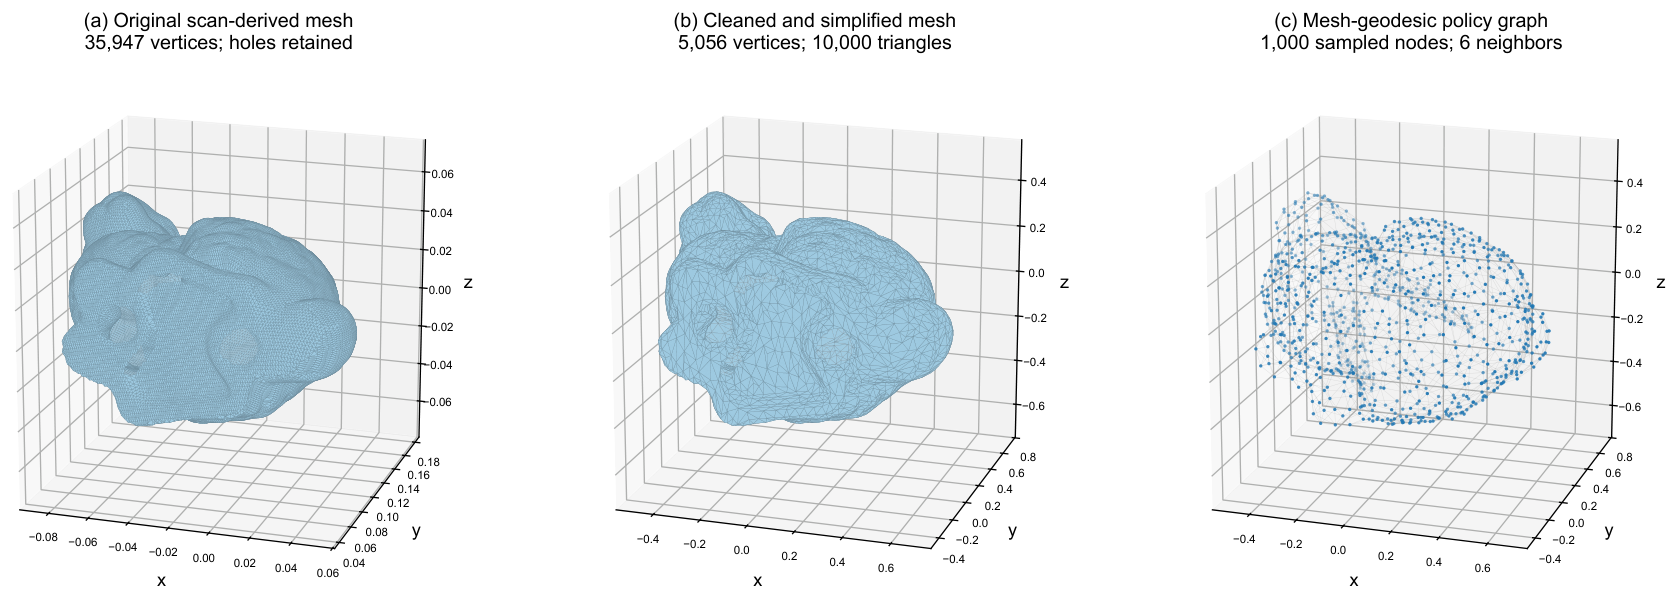
scan由来メッシュから簡略化メッシュと1000ノードのpolicy graphを構築する過程。出典: Z. Chen et al., “Graph-Enhanced Proximal Policy Optimization for Simulation-Based Point Cloud Coverage Planning on Curved Surfaces”, Figure 5, Actuators 15(9), 466 (2026).
今回のStanford bunny
今回のStanford bunnyは、曲面上をどの順番で巡回すれば、限られた移動回数で価値の高い領域を効率よくcoverできるかを調べる評価に使われています。入力はStanford 3D Scanning Repositoryのbun_zipper.plyです。
元メッシュは35,947頂点・69,451三角形で、10,000三角形・5,056頂点まで簡略化されます。そこからfarthest-point samplingで1,000個のpolicy nodeを選びます。取得時のholeは埋めず、223 boundary edgesと5 boundary loopsを保持しています。
空間的には近いが表面上では離れている場所へ飛び移らないよう、移動候補、edge length、coverage、priority distanceはmesh geodesic distanceで定義されます。穴は塞がれませんが、穴越しの近道は禁止されています。
今回の扱い:メッシュを簡略化され、1,000ノードの表面グラフにされ、PPOエージェントに巡回される
状態:その他(経路計画用データへ変換)
論文の内容
Coverage planningをgraphとして扱う
surface pointをnodeとし、近傍点への移動をedgeとするgraph上で、限られたdecision数の中でcoverageを最大化します。各stepでは6近傍のどれかをactionとして選択します。
policy optimizationにはPPOを利用し、更新前後のpolicy差が大きくなりすぎないようclipped objectiveで学習します。
Node featureとGCN
各nodeには3次元位置、covered state、current position、previous positionを表す6次元featureを持たせます。
GCNではneighborのfeatureをmean aggregationし、2層後の64次元embeddingをactorへ渡します。Global-MLP-PPOも用意し、全node情報を見るだけの効果とgraph adjacencyを利用する効果を分けて評価しています。
Candidate scoringを追加する
Graph-Enhanced PPOでは、current nodeとcandidate nodeのembedding、edge length、coverage stateを入力する追加MLP scorerを置きます。
ただしこのscorerは8,449個のparameterを追加するため、改善がcandidate scoringそのものによるのか、model capacity増加によるのかは完全には分離されていません。
人工曲面での評価
concave bowl、saddle、wavy surfaceの200-node graphで比較します。static uniform coverageではLocal-PPO 9.85%、Global-MLP-PPO 22.13%、GCN-PPO 76.97%、Graph-Enhanced PPO 88.37%、DFS 95.80%でした。
均等に全体を回るだけならDFSが最も高く、学習法の利点は有限budgetやpriorityのある問題で現れやすいと整理されています。
有限budgetと複雑形状
50 decisionsのpriority-weighted taskではGCN系2手法の差はほぼなく、weighted coverage 0.812対0.811でした。
独立したscan-derived validationでは1000 policy nodesを使い、平均edge lengthに合わせて112 decisionsへ増やしています。weighted coverageは0.450 ± 0.032対0.445 ± 0.030で、有意差はありませんでした。
一方、Standard DFSとの差は有限budget条件で有意でした。
制約
出力はsurface graph上のwaypoint sequenceであり、robot joint trajectoryではありません。IK、reachability、collision-free joint motion、tool orientation、contact forceなどは扱いません。
またscan-derived validationは1形状だけであり、一般的なindustrial scan noiseやregistration errorへのrobustnessまでは確認されていません。
論文情報
Graph-Enhanced Proximal Policy Optimization for Simulation-Based Point Cloud Coverage Planning on Curved Surfaces
Zhongxiang Chen, Zeng Feng, Zewu Li, Xingni Jiang, Biju Yin
- Published: 2026年9月1日
- Journal: Actuators 15(9), 466
- DOI: https://doi.org/10.3390/act15090466
- 分野: Coverage Path Planning / Reinforcement Learning / Graph Neural Network
- 使用モデル: Stanford bunny
- 使用ファイル: bun_zipper.ply
- 使用箇所: Section 3.1、3.3.3、4.6、Figures 5・6、Table 7
- 元メッシュ: 35,947 vertices / 69,451 triangles
- 簡略化後: 5,056 vertices / 10,000 triangles
- policy nodes: 1,000
- evaluation horizon: 112 decisions
- 用途: geodesic graph上の有限budget coverage planning評価